[수리통계1/수리통계2/회귀분석] 강의 및 교재 오류모음
안녕하세요, 김영우입니다. 수리통계1/수리통계2/회귀분석 강의와 교재에서 오류가 있는 부분 정리해드립니다.
해당 글은 주기적으로 업데이트 됩니다. (최종수정일 2026-08-01)
# 수리통계1
● [1장 Probability and Distribution] 1강 Probability Measure: Axiom (41분 50초경 부터)
Proposition 4번의 (b)번 증명과정에서 아래와 같은 오타가 있습니다.
\[ \bigcup_{k=1}^\infty E_k = \bigcup_{k=1}^n {\color{red} E_n} \qquad\Longrightarrow\qquad \bigcup_{k=1}^\infty E_k = \bigcup_{k=1}^n {\color{red} E_k} \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [1장 Probability and Distribution] 4강 Independent Event
Example 11번에서 교재를 보시면 \(\mathbb P(A_D \mid A) = 0.94\)로 주어져 있습니다. 하지만 강의를 보시면 제가 \(\mathbb P(A_D \mid A) = 0.96\)이라 착각하고 설명을 드립니다. 해당부분은 편의를 위해 교재를 \(\mathbb P(A_D \mid A) = 0.96\)로 고쳐주시기 바랍니다.
*** 확인해주신 "다온" 수강생님께 감사드립니다.
● [1장 Probability and Distribution] 5강 Random Variable and Distribution (19분 23초경)
교재 30페이지 Remark에서 \(X\)는 random variable이므로 "joint"라는 표현은 빼는 것이 맞습니다.
*** 확인해주신 "김지민" 수강생님께 감사드립니다.
● [1장 Probability and Distribution] 7강 Cumulative Distribution Function (2) & Discrete Random Variable (1) (32분 15초경 부터)
해당 파트에서 discrete random variable \(X\)의 support \(\mathcal X\)가 countable하다는 사실을 증명해드리는 과정에서 오타가 있었습니다.
\[ \mathcal X = \{x \in {\color{red} \mathbb R^n} : p_X(x) > 0\} \qquad\Longrightarrow\qquad \mathcal X = \{x \in {\color{red} \mathbb R} : p_X(x) > 0\} \] *** 확인해주신 "Ljsstudy" 수강생님께 감사드립니다.
● [1장 Probability and Distribution] 9강 Expectation (1) (37분 50초경 부터)
Definition 36번 (c)에서 skewness가 양수이고 음수일 때 PDF 형태를 예시로 설명드리는 부분입니다. 해당 파트에서 skewness의 부호에 따른 PDF의 모양을 반대로 설명드렸습니다. 대칭형태의 PDF를 기준으로 왼쪽으로 치우친 분포는 skewness가 양수이고 오른쪽으로 치우친 분포가 음수가 됩니다. 정확한 형태는 아래의 그림을 참고해주시기 바랍니다.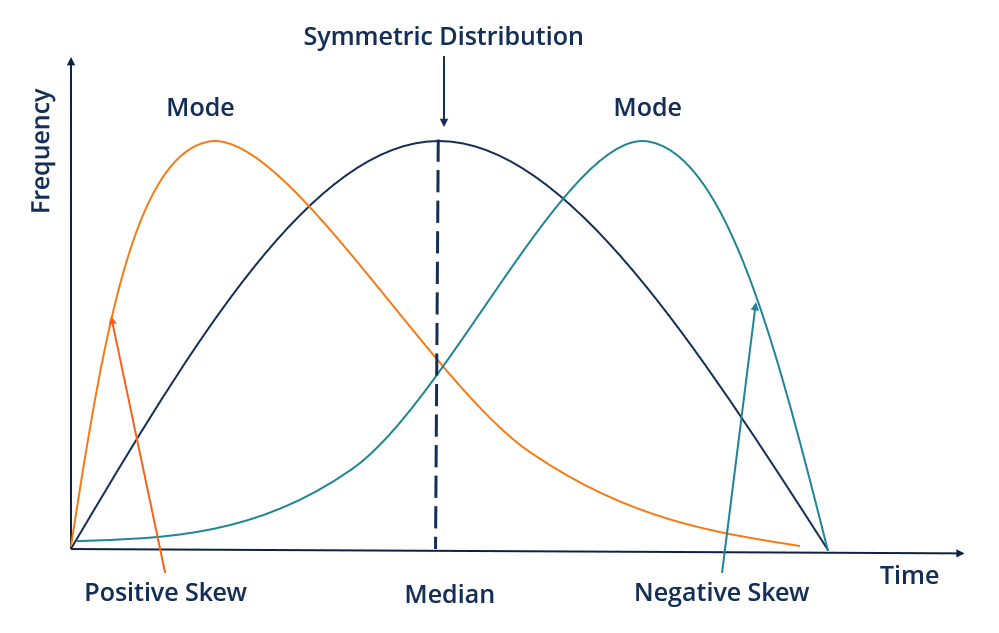
*** 확인해주신 "Josh" 수강생님께 감사드립니다.
● [1장 Probability and Distribution] 10강 Expectation (2) & Moment Generating Function (1) (30분 50초경 부터)
Theorem 40번 증명과정에서 임의의 정수 \(k\)에 대해서 다음과 같은 부등식이 성립하도록 하는 상수 \(A > 0\)가 존재한다고 설명드렸습니다.
\[ x^k \leq A e^{tx} \qquad\forall~ x \geq 0. \] 하지만 이는 \(k\)는 임의의 정수가 아닌 임의의 자연수일 때 성립하는 이야기입니다. 참고로 위의 \(k\)가 자연수일 때에만 위의 주장이 성립하더라도 Theorem 40을 증명하기에는 여전히 충분합니다.
*** 확인해주신 "파이팅" 수강생님께 감사드립니다.
● [1장 Probability and Distribution] 13강 Jensen and Lyapunov Inequality (20분 40초경 부터)
함수 \(\phi\)에 테일러 정리를 적용하는 과정에서 오류가 있었습니다.
\[ \phi(x) = \phi(c) + \phi'(c)(x-c) + {\color{red} \phi''(c^*)(x-c)^2} \qquad\Longrightarrow\qquad \phi(x) = \phi(c) + \phi'(c)(x-c) + {\color{red} \frac{1}{2!}\phi''(c^*)(x-c)^2} \] 다만 오른쪽과 같이 바꾸어주더라도 Jensen 부등식의 증명 논리는 여전히 성립합니다.
*** 확인해주신 "파이팅" 수강생님께 감사드립니다.
● [1장 Probability and Distribution] 16강 연습문제 풀이 (2) (33분경 부터)
Question 10을 풀이하면서 상수 \(\alpha\)의 범위를 나누어 \(X\)의 기댓값을 계산하는 과정에서 오류가 있었습니다. 아래와 같이 빨간색으로 표기한 항을 추가해주셔야 합니다.
\[ \mathbb E |X| = \int_1^\infty \alpha x^{-\alpha} \,dx = \begin{cases}
\displaystyle \biggl[ \alpha \log x \biggr]_1^\infty &(\alpha = 1) \\
\displaystyle \biggl[ \frac{{\color{red} \alpha}}{1-\alpha} \frac{1}{x^{\alpha-1}} \biggr]_1^\infty &(\alpha \not= 1) \end{cases} \] 다만 적분값이 유한한지를 판단하는 과정이므로 위와 같이 \(\alpha\)를 추가해주더라도 동일한 논리가 성립합니다.
*** 확인해주신 "12A" 수강생님께 감사드립니다.
● [1장 Probability and Distribution] 17강 연습문제 풀이 (3)
Question 14 (b)를 증명하는 과정에서 유일하다는 부분은 증명하지 않고 넘어가 이곳에 간단하게 설명드리겠습니다. 유일성은 아래의 식을 만족하는 \(a \in \mathbb R\)은 \(a = m\)인 median 뿐이라는 사실을 보이면 충분합니다.
\[ \int_m^a (a-x) f(x) dx = 0. \] 증명은 귀류법을 사용해 해당 등식을 만족하는 \(a \not= m\)이 존재하면 모순이 발생한다는 사실을 확인할 예정입니다. 첫 번째로 위의 등식을 만족하는 \(m < a\)인 \(a\)가 존재한다고 가정해보겠습니다. 그렇다면 임의의 \(a < x < m\)에 대해서 \(a-x > 0\)이고 \(f(x) \geq 0\)이므로 \(f(x) = 0\)이 반드시 성립해야 합니다. 그런데 이 경우 \(a\)도 median이 되면서 median이 유일하다는 가정에 모순이 생깁니다.
\[ \mathbb P(X \leq a) = \mathbb P(X \leq m) + \int_m^a f(x) dx = \frac12. \] 한편 등식을 만족하는 \(m > a\)가 존재하는 경우에도 같은 논리로 모순을 보일 수 있습니다.
*** 확인해주신 "Ljsstudy" 수강생님께 감사드립니다.
● [2장 Multivariate Distribution] 25강 Expectation (34분 20초경 부터)
Theorem 67 (a)를 증명하는 과정에서 행렬곱을 설명해드리는 부분에 오타가 있었습니다. 행렬 \(C = (C_{ij})\)와 행렬 \(D = (D_{jk})\)를 정의한 상태에서 행렬곱 \(CD\)는 다음과 같이 정의됩니다.
\[ CD = \bigl( (CD)_{\color{red} ik} \bigr) \quad\text{where}~ (CD)_{\color{red} ik} = \sum_{j} C_{ij} D_{jk} \] 강의 중에는 빨간색으로 표시된 index 부분에 오타가 있었습니다.
*** 확인해주신 "Ljsstudy" 수강생님께 감사드립니다.
● [2장 Multivariate Distribution] 45강 연습문제 풀이 (3) (37분 6초경 부터)
Question 12번의 (a)번 설명드리는 과정에서 아래와 같은 오타가 있습니다.
\[ \begin{align*} &\mathbb E \big(X_2 - a - bX_1)^2 = \cdots \geq \mathbb E \left( {\color{red} X_1} - \mu_2 - \rho\frac{\sigma_2}{\sigma_1}(X_1-\mu_1) \right)^2 \\ &\Longrightarrow\qquad \mathbb E \big(X_2 - a - bX_1)^2 = \cdots \geq \mathbb E \left( {\color{red} X_2} - \mu_2 - \rho\frac{\sigma_2}{\sigma_1}(X_1-\mu_1) \right)^2 \end{align*} \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [2장 Multivariate Distribution] 46강 연습문제 풀이 (4) (15분 15초경 부터)
Question 13번의 (c)번 증명하는 과정에서 아래와 같은 오타가 있습니다.
\[ \begin{align*} &\mathbb P \big(X > 2 \mid X > x_0) = \int_2^\infty \frac{f(x)}{1-F(x)} \mathbb I(x > x_0) \,{\color{red} dx_0} \\ &\Longrightarrow\qquad \mathbb P \big(X > 2 \mid X > x_0) = \int_2^\infty \frac{f(x)}{1-F(x)} \mathbb I(x > x_0) \,{\color{red} dx} \end{align*} \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [교재 3장 Some Special Distributions] 50페이지 Theorem 41의 Proof
교재에서 아래와 같이 부등식으로 표기된 부분을 등식으로 고쳐주셔야 합니다.
\[ g(n, t+h) = \mathbb P(N_{t+h} = n) \:{\color{red} \leq}\: \cdots \qquad\Longrightarrow\qquad g(n, t+h) = \mathbb P(N_{t+h} = n) \:{\color{red} =}\: \cdots \] *** 확인해주신 "12A" 수강생님께 감사드립니다.
● [교재 3장 Some Special Distributions] 77페이지 Definition 65
\(X\)는 random vector이지만 random variable로 오타가 있습니다.
*** 확인해주신 "파이팅" 수강생님께 감사드립니다.
● [교재 3장 Some Special Distributions: Problem Set] 3페이지 Question 2
(a)번 문제를 풀어드리는 과정에서 칠판에 적어드린 부분에 오타가 있습니다.
\[ \begin{align*} &M_{X_1,\ldots, X_r, X_{r^*}}(t_1,\ldots, t_r, t_{r+1}) = \cdots = M_{X_1,\ldots,{\color{red} X_n}}(t_1-t_{r+1},\ldots, t_r-t_{r+1},0,\ldots,0) \\ &\Longrightarrow M_{X_1,\ldots, X_r, X_{r^*}}(t_1,\ldots, t_r, t_{r+1}) = \cdots = M_{X_1,\ldots,{\color{red} X_k}}(t_1-t_{r+1},\ldots, t_r-t_{r+1},0,\ldots,0) \end{align*} \] *** 확인해주신 "ㅎㅈ" 수강생님께 감사드립니다.
(b)번 문제의 수식에서 아래와 같은 오타가 있습니다.
\[ \begin{align*} &f(x_{r+1}, \ldots, x_k \mid x_1, \ldots, x_r) = \binom{x_r^*}{x_{r+1}, \ldots, x_k} \left( \frac{p_{r+1}}{p_r^*} \right)^{x_{r+1}} \cdots {\color{red} \left( \frac{p_n}{p_r^*} \right)^{x_n}} \mathbb I(\cdots) \\ &\Longrightarrow\qquad f(x_{r+1}, \ldots, x_k \mid x_1, \ldots, x_r) = \binom{x_r^*}{x_{r+1}, \ldots, x_k} \left( \frac{p_{r+1}}{p_r^*} \right)^{x_{r+1}} \cdots {\color{red} \left( \frac{p_k}{p_r^*} \right)^{x_k}} \mathbb I(\cdots) \end{align*} \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
추가로 (b)번 문제에 대해서 강의시간에 잘못 설명드린 부분이 있어서 정정해드리고자 합니다. 해당 파트에서 제가 \((X_1, \ldots, X_r)\)의 joint distribution이 multinomial distribution을 따른다고 설명드렸습니다. 하지만 이는 사실이 아니며 (a)에서 증명한바와 같이 \((X_1, \ldots, X_r, X_r^*)\)이 multinomial distribution을 따릅니다. 저희는 해당 사실을 활용해서 \((X_1, \ldots, X_r)\)의 pdf를 추가로 계산해주어야 합니다. 문제에서 정의한 새로운 확률변수 \(X_r^* = n-(X_1 + \ldots + X_r)\)의 정의로부터 다음의 등식이 성립합니다.
\[ \begin{align*} f_{X_1, \ldots, X_r}(x_1, \ldots, x_r) &= \mathbb P(X_1 = x_1, \ldots, X_r = x_r) \\ &= \mathbb P(X_1 = x_1, \ldots, X_r = x_r, X_r^* = n-x_1 - \cdots - x_r) \\ &= f_{X_1, \ldots, X_r, X_r^*}(x_1, \ldots, x_r, n-x_1 - \cdots - x_r) \end{align*} \] 따라서 맨 마지막 항에 multinomial distribution의 pdf를 적용하여 \((X_1, \ldots, X_r)\)의 pdf를 계산할 수 있습니다. 이를 활용해주시면 최종적으로 문제의 형태와 같은 conditional distribution도 얻으실 수 있습니다.
*** 확인해주신 "청년경찰" 수강생님께 감사드립니다.
● [교재 3장 Some Special Distributions: Problem Set] 10페이지 Question 10
(a)번 문제의 수식에서 아래와 같은 오타가 있습니다.
\[ \begin{align*} &1-\Phi(x) = \cdots = \frac{\phi(x)}{x} \int_0^\infty \exp\left( -y - \frac{y^2}{2x^2} \right) \, {\color{red} dz} \\ &\Longrightarrow\qquad 1-\Phi(x) = \cdots = \frac{\phi(x)}{x} \int_0^\infty \exp\left( -y - \frac{y^2}{2x^2} \right) \,{\color{red} dy} \end{align*} \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [3장 Some Special Distributions] 51강 Transformation of Random Variable (3) (4분 4초경 부터)
Example 13번을 증명하는 과정에서 \(x_2^2 = y_2(1-y_2)\)와 같은 수식을 \(x_2\)에 대해서 전개합니다. 해당 과정에서 아래와 같은 오타가 있습니다.
\[ {\color{red} x_2^2} = \pm\sqrt{y_2(1-y_2)} \qquad\Longrightarrow\qquad {\color{red} x_2} = \pm\sqrt{y_2(1-y_2)} \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [3장 Some Special Distributions] 59강 Gamma Distribution and Poisson Process (36분 55초경 부터)
해당 부분에서는 Theorem 48을 \(r=2\)인 경우에 증명한 아이디어를 확장해서 일반적인 \(r\)에 대해서 Theorem 48을 증명하는 방법을 다룹니다. 이 부분에서 아래와 같이 \(\cdots\)부분을 생략해서 등식을 써드렸는데요, 이에 대한 부연설명을 조금 더 자세히 설명드리고자 합니다.
\[ \mathbb P(N_{w_1} = 0, N_{w_2} \leq 1, N_{w_3} \leq 2, \ldots) = \mathbb P(N_{w_1} = 0, N_{w_2}-N_{w_1} \leq 1, N_{w_3} - N_{w_2} \leq 1, \ldots) + \cdots \] 여기서 \(\cdots\)부분은 무시해주셔도 pdf를 구할 때에는 무시하셔도 상관이 없기에 \(\cdots\)으로 표기하였습니다. 왜냐하면 저희는 결국 계산된 결과를 \(w_1, \ldots, w_r\)로 미분할텐데, \(\cdots\)부분은 미분하면 0이 나오기 때문입니다. 이를 간단하게 설명드리기 위해서 편의상 \(r=3\)이라고 가정하겠습니다. 그렇다면 \(\cdots\)부분을 아래와 같이 정확히 쓸 수 있습니다.
\[ \mathbb P(N_{w_1} = 0, N_{w_2} \leq 1, N_{w_3} \leq 2) = \mathbb P(N_{w_1} = 0, N_{w_2}-N_{w_1} \leq 1, N_{w_3} - N_{w_2} \leq 1) + \mathbb P(N_{w_1} = 0, N_{w_2}-N_{w_1} = 0, N_{w_3} - N_{w_2} = 2) \] 그런데 맨 마지막 식을 잘 보시면 다음과 같은 등식이 성립합니다.
\[ \mathbb P(N_{w_1} = 0, N_{w_2}-N_{w_1} = 0, N_{w_3} - N_{w_2} = 2) = \mathbb P(N_{w_2} = 0, N_{w_3} - N_{w_2} = 2) \] 다시 말해서 \(r=3\)인 경우 \(\cdots\)에 해당하는 항은 \(w_1\)에 전혀 의존하지 않는 형태가 됩니다. 따라서 \(w_1\)으로 미분하면 0이 나오겠습니다. 비슷한 논리로 임의의 \(r\)에 대해서 생각해보시면 \(\cdots\)부분은 \(w_1, \ldots, w_r\)로 미분하면 항상 0이 나오게 됩니다.
*** 확인해주신 "청년경찰" 수강생님께 감사드립니다.
● [3장 Some Special Distributions] 62강 Normal Distribution & Chi-squared Distribution (1) (36분 15초경 부터)
Theorem 57번의 (b)번을 증명하는 과정에서 아래와 같이 \(\exp\)부분이 생략된 오타가 있습니다.
\[ \int_{-\infty}^\infty \frac{1}{\sqrt{2\pi\sigma^2}} {\color{red} \left( -\frac{z^2}{2\sigma^2} \right)} \,dz \cdot (1-2t)^{-1/2} \qquad\Longrightarrow\qquad \int_{-\infty}^\infty \frac{1}{\sqrt{2\pi\sigma^2}} {\color{red} \exp\left( -\frac{z^2}{2\sigma^2} \right)} \,dz \cdot (1-2t)^{-1/2} \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [3장 Some Special Distributions] 63강 Chi-squared Distribution (2) & t-distribution (1) (15분 50초경 부터)
증명을 하는 중간에 \(+s/n\)이 \(-s/n\)으로 갑자기 부호가 바뀝니다. 이는 계산과정의 실수이니 이후 전개과정에서 해당부분을 모두 \(+s/n\)으로 바꿔주셔야 합니다. 다만 부호를 바꾸시더라도 \(s\)와 \(t_1, \ldots, t_n\)은 여전히 쪼개지는 형태로 나오므로, 독립이라는 결론에 변함은 없습니다.
*** 확인해주신 "샤라포바" 수강생님께 감사드립니다.
● [3장 Some Special Distributions] 64강 t-distribution (2) & F-distribution (23분경 부터)
강의에서 F분포의 pdf를 증명하는 중간에 다음 수식의 첫 번째 등식을 사용합니다. 하지만 이는 잘못된 것으로 다음 수식의 두 번째 등식을 사용해주셔야 하고, 오타가 있는 부분은 빨간색으로 표시되어 있습니다. 참고로 해당 등식은 Gamma분포의 pdf를 떠올려보시면 쉽게 확인하실 수 있습니다.
\[ \begin{align*} &\int_0^\infty f_2^{\frac{r_1+r_2}{2}-1} e^{-\frac{1}{2}\left(\frac{r_1}{r_2}f_1 + 1\right) f_2} \,df_2 = \Gamma\left( \frac{r_1+r_2}{2} \right) \left[ {\color{red} \frac{1}{2}\left(\frac{r_1}{r_2}f_1 + 1\right)} \right]^{\frac{r_1+r_2}{2}} \\ &\Longrightarrow\qquad \int_0^\infty f_2^{\frac{r_1+r_2}{2}-1} e^{-\frac{1}{2}\left(\frac{r_1}{r_2}f_2 + 1\right) f_2} \,df_2 = \Gamma\left( \frac{r_1+r_2}{2} \right) \left[ {\color{red} 2\left(\frac{r_1}{r_2}f_1 + 1\right)^{-1}} \right]^{\frac{r_1+r_2}{2}} \end{align*} \] *** 확인해주신 "파이팅" 수강생님께 감사드립니다.
● [3장 Some Special Distributions] 74강 연습문제 풀이 (3) (37분 24초경 부터)
Question 22의 (b)번을 증명하는 과정에서 다변량 정규분포의 조건부 분포를 계산하는 공식을 사용합니다. 다만 여기서 왼쪽과 같이 공식을 적어드렸는데, 이는 오류가 있으므로 오른쪽과 같이 바꾸어주셔야 합니다.
\[ X_1 \mid X_2=x_2 \sim N\big(\mu_1 + {\color{red} \Sigma_{11}^{-1}\Sigma_{12}}(x_2-\mu_2),\, \Sigma_{11\cdot2} \big) \qquad\Longrightarrow\qquad X_1 \mid X_2=x_2 \sim N\big(\mu_1 + {\color{red} \Sigma_{12}\Sigma_{22}^{-1}}(x_2-\mu_2),\, \Sigma_{11\cdot2}\big) \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [4장 Limit of Random Variables] 81강 Convergence in Probability (29분 21초경 부터)
증명을 하는 중간에 \( \sum_{j=1}^k |Y_{nj}-{\color{red} Y}| > k \)로 서술하는 부분이 있습니다. 이는 표기상의 실수이니 \( \sum_{j=1}^k |Y_{nj}-{\color{red} Y_j}| > k \) 로 바꾸어주셔야 합니다.
*** 확인해주신 "샤라포바" 수강생님께 감사드립니다.
● [4장 Limit of Random Variables] 89강 Convergence in Distribution: Property (2) (5분 26초경 부터)
Theorem 36번을 증명하는 과정에서 아래의 두 번째 등식과 같이 여사건을 이용해 논의를 전개합니다. 해당 과정에서 앞에 있는 두 항의 부호는 아래의 수식과 같이 모두 반대로 바꾸어주어야 합니다.
\[ \begin{aligned} &\mathbb P\big( |X_n| > M \big) = \mathbb P\big( |X_n| > M \big) - \mathbb P\big( |X| > M \big) + \mathbb P\big( |X| > M \big) = {\color{red} \mathbb P\big( |X_n| \leq M \big) - \mathbb P\big( |X| \leq M \big)} + \mathbb P\big( |X| > M \big) \\ &\Longrightarrow\qquad \mathbb P\big( |X_n| > M \big) = \mathbb P\big( |X_n| > M \big) - \mathbb P\big( |X| > M \big) + \mathbb P\big( |X| > M \big) = {\color{red} -\mathbb P\big( |X_n| \leq M \big) + \mathbb P\big( |X| \leq M \big)} + \mathbb P\big( |X| > M \big) \end{aligned} \] 참고로 두 번째 등식에서는 아래와 같은 사실을 이용하였습니다.
\[\mathbb P\big( |X_n| > M \big) = 1 - \mathbb P\big( |X_n| \leq M \big). \] 여기서 부호를 바꾸어주더라도 이후의 논리는 여전히 성립합니다. 왜냐하면 비슷한 논리로 다음의 수식이 성립하기 때문입니다.
\[ -\mathbb P\big( |X_n| \leq M \big) + \mathbb P\big( |X| \leq M \big) \xrightarrow{n\to\infty} 0. \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [4장 Limit of Random Variables] 92강 Delta Method (1) (31분 30초경 부터)
해당 파트에서 수식을 전개하는 과정에서 부호에 오류가 있었습니다.
\[\begin{align*} &\sqrt{n}(S_n^2 - \sigma^2) = \sqrt{n}\left( \frac{n}{n-1}T_n - \sigma^2 \right) = \sqrt{n}(T_n^2 - \sigma^2) \,{\color{red} -}\, \frac{\sqrt{n}}{n-1} T_n^2 \\ &\Longrightarrow\quad \sqrt{n}(S_n^2 - \sigma^2) = \sqrt{n}\left( \frac{n}{n-1}T_n - \sigma^2 \right) = \sqrt{n}(T_n^2 - \sigma^2) \,{\color{red} +}\, \frac{\sqrt{n}}{n-1} T_n^2 \end{align*}\] 다만 이렇게 부호가 바뀌더라도 마지막 항은 여전히 0으로 확률수렴(convergence in probability)하므로 결론에는 변함이 없겠습니다.
*** 확인해주신 "Ljsstudy" 수강생님께 감사드립니다.
● [4장 Limit of Random Variables] 93강 Delta Method (2) (35분 30초경 부터)
해당 파트에서는 Example 48에서 독립이 아닌 \(X_1\)과 \(Y_1\)을 독립인 \(W_1\)과 \(Z_1\)으로 변환합니다. 이를 정의하고 적어드리는 과정에서 오류가 있었습니다. \(W_1\)과 \(Z_1\)는 다음과 같이 정의해주셔야 합니다.
\[ \begin{pmatrix} W_1 \\ Z_1 \end{pmatrix} = \begin{pmatrix} (X_1 - \rho Y_1) / \sqrt{1-\rho^2} \\ Y_1 \end{pmatrix} = \begin{pmatrix} 1/\sqrt{1-\rho^2} & -\rho/\sqrt{1-\rho^2} \\ 0 & 1 \end{pmatrix} \begin{pmatrix} X_1 \\ Y_1 \end{pmatrix} \] 그리고 \((W_1, Z_1)\)의 공분산행렬을 계산해주시면 identity matrix가 나옵니다:
\[ \mathrm{Var}(W_1) = \mathrm{Var}(Z_1) = 1 \quad\text{and}\quad \mathrm{Cov}(W_1, Z_1) = 0. \] 즉 \(W_1\)과 \(Z_1\)는 모두 독립인 standard Gaussian random variable이 되므로 이후의 논리전개는 모두 유효합니다.
*** 확인해주신 "임예림" 수강생님께 감사드립니다.
● [4장 Limit of Random Variables] 94강 연습문제 풀이 (1) (16분 20초경 부터)
Question 2를 풀어드리는 과정에서 다음과 같은 계산 실수가 있습니다.
\[ \mathbb P(Z_n \leq z) = \cdots = \left[ 1 - \left( 1 - \frac{z^\alpha}{n} \right)^n \right] \mathbb I(0 < z^\alpha < n) + \big( 1 - 1^n \big) \mathbb I(z \leq 0) = \left[ 1 - \left( 1 - \frac{z^\alpha}{n} \right)^n \right] \mathbb I(0 < z^\alpha < n) \] 결론적으로 강의시간에 적어드린 두 번째 항 \(\mathbb I(z^\alpha \geq n)\)은 등장하지 않고 사라지는 것이 맞습니다. 물론 오류를 수정한 상태로 \(n\)을 무한대로 보내주시더라도 극한값은 여전히 동일하게 나옵니다.
*** 확인해주신 "bbq12340" 수강생님께 감사드립니다.
# 수리통계2
● [5장 Statistical Estimation] 교재 84페이지 Example 63
감마분포의 Fisher information 부분에 오타가 있습니다. 왼쪽을 오른쪽과 같이 수정해주셔야 합니다.
\[ I_1(\theta) = \begin{bmatrix} \dot{\Psi}(\alpha) & 1/\beta \\ 1/\beta & {\color{red} 3\alpha/\beta^2} \end{bmatrix} \qquad\Longrightarrow\qquad I_1(\theta) = \begin{bmatrix} \dot{\Psi}(\alpha) & 1/\beta \\ 1/\beta & {\color{red} \alpha/\beta^2} \end{bmatrix} \] *** 확인해주신 "파이팅" 수강생님께 감사드립니다.
● [5장 Statistical Estimation] 11강 Maximum Likelihood Estimation (4) (38분경 부터)
Example 39의 증명과정 log-likelihood를 계산합니다. 하지만 아래 수식에서 왼쪽과 같이 칠판에 서술한 결과는 잘못된 것으로 오른쪽과 같이 수정해주셔야 합니다.
\[ \ell(\theta;x) = -{\color{red}\frac{1}{2}}\log(2\pi) + \cdots \qquad\Longrightarrow\qquad \ell(\theta;x) = -{\color{red}\frac{n}{2}}\log(2\pi) + \cdots \] 다만 해당 항은 여전히 상수이므로 \(\theta\)의 MLE를 유도하는데에는 영향을 미치지 않습니다.
*** 확인해주신 "통계꿀잼" 수강생님께 감사드립니다.
● [5장 Statistical Estimation] 13강 Maximum Likelihood Estimation: Asymptotic Theory (1) (18분경 부터)
Example 44의 2번 Bernoulli 예제를 설명드리면서 \(\eta\)의 MLE를 먼저 유도합니다. 하지만 아래 수식에서 왼쪽과 같이 칠판에 서술한 결과는 잘못된 것으로 오른쪽과 같이 수정해주셔야 합니다.
\[ \widehat{\eta}^{MLE} = \frac{e^{\overline x}}{1 + e^{\overline x}}. \qquad\Longrightarrow\qquad \widehat{\eta}^{MLE} = \log\frac{\overline x}{1 - \overline x}. \] 이는 강의에서 설명드린 것처럼 아래의 방정식을 직접 풀어보시면 확인하실 수 있습니다.
\[ \overline{x} = \frac{e^\eta}{1+e^\eta}. \] 이를 활용해서 \(\theta\)의 MLE를 계산해보시면 \(\overline x\)가 나온다는 사실도 최종적으로 확인하실 수 있습니다.
*** 확인해주신 "통계열공" 수강생님께 감사드립니다.
● [5장 Statistical Estimation] 16강 Maximum Likelihood Estimation: Asymptotic Theory (4) (37분 20초경 부터)
Theorem 58 증명과정의 동그라미 3번에 해당하는 부분입니다. 강의에서는 상수 \(C>0\)를 왼쪽과 같이 잡아드렸지만 원하는 결과를 얻으려면 오른쪽과 같이 수정해주셔야 합니다.
\[ C = \frac{\varepsilon/2}{\mathbb E_{\theta_0} M(X_1)} \qquad\Longrightarrow\qquad C = \frac{\varepsilon}{2} \mathbb E_{\theta_0} M(X_1). \] 오른쪽을 적용해주시면 \(\mathbb E_{\theta_0} M(X_1)\)는 약분되어 사라지고 부등식의 마지막 항에는 최종적으로 \(\epsilon\)만 남겠습니다.
*** 확인해주신 "설통가고파" 수강생님께 감사드립니다.
● [5장 Statistical Estimation] 22강 Confidence Interval (3) (24분경 부터)
Example 73의 증명과정에서, 위와 같이 칠판에 서술한 결과는 잘못된 것으로 아래과 같이 수정해주셔야 합니다.
\[ \begin{align*} &\sqrt{n_1}(\widehat{\theta}_1 - \theta_1) - \sqrt{n_1}(\widehat{\theta}_2 - \theta_2) = {\color{red} \sqrt{n}} \Big( \widehat{\theta}_1 - \widehat{\theta}_2 - (\theta_1 - \theta_2) \Big), \\ &\Longrightarrow\qquad \sqrt{n_1}(\widehat{\theta}_1 - \theta_1) - \sqrt{n_1}(\widehat{\theta}_2 - \theta_2) = {\color{red} \sqrt{n_1}} \Big( \widehat{\theta}_1 - \widehat{\theta}_2 - (\theta_1 - \theta_2) \Big). \end{align*} \] *** 확인해주신 "통계꿀잼" 수강생님께 감사드립니다.
● [교재 6장 Statistical Hypothesis Testing] 32페이지 마지막 문장
shown이 shonw으로 표기된 오타가 있습니다.
*** 확인해주신 "통계란찜" 수강생님께 감사드립니다.
● [교재 6장 Statistical Hypothesis Testing] 38페이지 Example 13
Likelihood ratio test statistic \(L_n\)을 다음과 같이 수정해주셔야 합니다.
\[ L_n = 2n \sum_{j=1}^k\widehat\theta_j \log\frac{\widehat\theta_j}{\xi_{j}}. \] *** 확인해주신 "청년경찰" 수강생님께 감사드립니다.
● [6장 Statistical Hypothesis Testing] 30강 Likelihood Ratio Test (2) (16분경 부터)
Example 4의 증명과정에서, log-likelihood ratio test statistic을 계산합니다. 하지만 왼쪽과 같이 칠판에 서술한 결과는 잘못된 것으로 오른쪽과 같이 수정해주셔야 합니다.
\[ n \log\left( 1+\frac{(\overline x - \mu_0)^2}{\widehat \sigma^2} \right) = n \log\left( 1+\left(\frac{\overline x - \mu_0}{S/\sqrt{n}}\right)^2 {\color{red} \frac{\sqrt{n}}{n-1}} \right) \qquad\Longrightarrow\qquad n \log\left( 1+\frac{(\overline x - \mu_0)^2}{\widehat \sigma^2} \right) = n \log\left( 1+\left(\frac{\overline x - \mu_0}{S/\sqrt{n}}\right)^2 {\color{red} \frac{1}{n-1}} \right) \] 이후의 수식에서도 \(\sqrt{n}\)에 해당하는 부분은 모두 제거해주시면 됩니다. 참고로 이와 같이 수정하시더라도 LR test를 유도하는 과정에는 논리적 문제가 없습니다.
*** 확인해주신 "통계꿀잼" 수강생님께 감사드립니다.
● [6장 Statistical Hypothesis Testing] 31강 Likelihood Ratio Test (3) (7분경 부터)
Example 5의 증명과정에서, 왼쪽과 같이 칠판에 서술한 결과는 잘못된 것으로 오른쪽과 같이 수정해주셔야 합니다.
\[ {\color{red} \frac{1}{2n}}(\ell - \ell) = f(\overline{x}/\theta_0) \qquad\Longrightarrow\qquad {\color{red} \frac{1}{n}}(\ell - \ell) = f(\overline{x}/\theta_0) \] 참고로 마이너스 앞쪽의 \(\ell\)은 전체 모수공간에 대한 MLE를 log-likelihood에 대입한 값을 의미하고, 마이너스 뒤쪽의 \(\ell\)은 귀무가설의 모수공간에 대한 MLE를 log-likelihood에 대입한 값을 의미합니다. (16페이지에서 유도한 내용 참조)
*** 확인해주신 "통계꿀잼" 수강생님께 감사드립니다.
● [6장 Statistical Hypothesis Testing] 32강 Likelihood Ratio Test (4) (18분 50초경 부터)
Example 6번의 증명과정에서 log-likelihood ratio statistic을 계산합니다. 다만 계산결과를 정리하는 과정에서 오류가 있으니 왼쪽을 오른쪽과 같이 바꿔주시기 바랍니다.
\[ \begin{aligned} &2\big( \ell(\widehat{\theta}^{\Theta};x,y) - \ell(\widehat{\theta}^{\Theta_0};x,y) \big) = (n_1+n_2) \log\left( 1 + \frac{n_1n_2}{{\color{red} n_1+n_2}}\left( \frac{\overline x - \overline y}{\widehat \sigma} \right)^2 \right) \\ &\Longrightarrow\qquad 2\big( \ell(\widehat{\theta}^{\Theta};x,y) - \ell(\widehat{\theta}^{\Theta_0};x,y) \big) = (n_1+n_2) \log\left( 1 + \frac{n_1n_2}{{\color{red} (n_1+n_2)^2}}\left( \frac{\overline x - \overline y}{\widehat \sigma} \right)^2 \right) \end{aligned} \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [6장 Statistical Hypothesis Testing] 37강 연습문제 풀이 (1) (14분경 부터)
Question 1번의 (b)번 풀이과정에서 아래와 같은 방식으로 \(\gamma\)값을 유도합니다. 여기서 두 확률을 합한 값은 0.5가 아니라 0.1(=문제에서 주어진 test의 size)이 되어야 합니다.
\[ \mathbb P_{\theta=0.5}(X_1 + \cdots + X_7 > 5) + \gamma\,\mathbb P_{\theta=0.5}(X_1 + \cdots + X_7 = 5) = {\color{red} 0.5} \qquad\Longrightarrow\qquad \mathbb P_{\theta=0.5}(X_1 + \cdots + X_7 > 5) + \gamma\,\mathbb P_{\theta=0.5}(X_1 + \cdots + X_7 = 5) = {\color{red} 0.1} \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [6장 Statistical Hypothesis Testing] 39강 연습문제 풀이 (3) (26분 35초경 부터)
Question 5번의 (b)번 풀이과정에서 log-likelihood ratio statistic을 계산합니다. 다만 계산결과를 정리하는 과정에서 오류가 있으니 \(2\)를 추가로 곱해주셔야합니다.
\[ 2\big( \ell(\widehat{\theta}^{\Theta};x) - \ell(\widehat{\theta}^{\Theta_0};x) \big) = {\color{red} n} \big[ \!-\!\log(\widehat{\sigma}/\sigma_0) + \widehat{\sigma}/\sigma_0 - 1 \big] \qquad\Longrightarrow\qquad 2\big( \ell(\widehat{\theta}^{\Theta};x) - \ell(\widehat{\theta}^{\Theta_0};x) \big) = {\color{red} 2n} \big[ \!-\!\log(\widehat{\sigma}/\sigma_0) + \widehat{\sigma}/\sigma_0 - 1 \big] \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [6장 Statistical Hypothesis Testing] 40강 연습문제 풀이 (4) (22분 30초경 부터)
Question 7번의 LR test statistic \(L_n\)을 계산해드리는 과정에서 오타가 있었습니다. 오른쪽과 같이 \(n_i\)를 괄호 바깥으로 빼주셔야 합니다.
\[ L_n = 2\sum_{i=1}^{k} \left[ \frac{{\color{red} n_i} \overline{X}_i}{\overline{X}} - 1 - \log \frac{\overline{X}_i}{\overline{X}} \right] \qquad\Longrightarrow\qquad L_n = 2\sum_{i=1}^{k} {\color{red} n_i} \left[ \frac{\overline{X}_i}{\overline{X}} - 1 - \log \frac{\overline{X}_i}{\overline{X}} \right] \] *** 확인해주신 "12A" 수강생님께 감사드립니다.
● [7장 Comparison Between Estimators] 43강 Information Inequality (2) (10분 53초경 & 13분 44초경 부터)
Example 5번을 설명드리는 과정에서 오류가 두 군데 있습니다. 먼저 10분 53초경 \(\widehat{\eta}^2\)의 기대값 계산에 실수가 있습니다.
\[ \mathbb E_\theta(\widehat{\eta}^2) = {\color{red} \frac{1}{n^2}} \mathbb E_\theta \big( Y^2(n-Y)^2 \big) \qquad\Longrightarrow\qquad \mathbb E_\theta(\widehat{\eta}^2) = {\color{red} \frac{1}{n^4}} \mathbb E_\theta \big( Y^2(n-Y)^2 \big) \] 추가로 13분 44초경 \(Y^2(n-Y)^2\)을 변형하는 과정에서도 실수가 있습니다. 빨간색으로 표기한 마지막 항을 추가해주셔야 합니다.
\[ Y^2(n-Y)^2 = Y(Y-1)(Y-2)(Y-3) + A \cdot Y(Y-1)(Y-2) + B \cdot Y(Y-1) + {\color{red} C \cdot Y} \] 여기서 해당 등식이 항등식이 되도록 적당한 상수 \(A,B,C\)를 찾아주시면 됩니다. 참고로 빨간색으로 표기한 마지막 항이 없으면 항등식을 만들어줄 수 없습니다.
*** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [7장 Comparison Between Estimators] 46강 Rao-Blackwell Theorem (17분 50초경 부터)
Example 21의 (b)번 증명과정에서, 왼쪽과 같이 칠판에 서술한 결과는 잘못된 것으로 오른쪽과 같이 수정해주셔야 합니다.
\[ f(x_1, \ldots, x_n;\theta) = \frac{1}{\theta^n} \mathbb{I}( {\color{red} x_{(n)} \geq \theta},\, x_{(1)} \geq 0 ) \qquad\Longrightarrow\qquad f(x_1, \ldots, x_n;\theta) = \frac{1}{\theta^n} \mathbb{I}( {\color{red} x_{(n)} \leq \theta},\, x_{(1)} \geq 0 ) \] 참고로 오른쪽과 같이 수정하더라도 factorization theorem에 의해서 \(X_{(n)}\)이 sufficient statistic이라는 사실은 변하지 않습니다.
*** 확인해주신 "통계란" 수강생님께 감사드립니다.
● [7장 Comparison Between Estimators] 48강 Rao-Blackwell-Lehmann-Scheffe Theorem (40분 23초경 부터)
Example 25의 증명 과정에서 indicator로 적어드린 부분에 오타가 있습니다.
\[ \cdots = \mathbb I(y = 1, 2, \ldots, {\color{red} n}) \frac{n(n-y)}{n(n-1)} \qquad\Longrightarrow\qquad \cdots = \mathbb I(y = 1, 2, \ldots, {\color{red} n-1}) \frac{n(n-y)}{n(n-1)} \] 해당 부분은 \(\sum_{i=3}^{n} X_i = y-1\)에서 왼쪽 random variable\((\mathrm{Bin}(n-2, \theta))\)의 support를 고려한 결과입니다. 다만 \(y=n\)인 경우 왼쪽의 식도 0이 되므로 결과만 놓고 볼 경우에는 두 식이 정확하게 일치하므로 최종 결과에는 영향이 없습니다.
*** 확인해주신 "Ljsstudy" 수강생님께 감사드립니다.
● [7장 Comparison Between Estimators] 54강 연습문제 풀이 (1) (14분 32초경 부터)
Question 5번을 풀이하는 과정에서 \(X_1, \ldots, X_n\)의 joint pdf를 계산합니다. 여기서 왼쪽과 같이 서술해드렸는데, 오타가 있으므로 오른쪽과 같이 수정해주셔야 합니다.
\[ f(x_1, \ldots, x_n; \theta) = \prod_{i=1}^n \left( \sum_{k=1}^\infty \theta_k \mathbb I({\color{red} x}=k) \right) \qquad\Longrightarrow\qquad f(x_1, \ldots, x_n; \theta) = \prod_{i=1}^n \left( \sum_{k=1}^\infty \theta_k \mathbb I({\color{red} x_i}=k) \right) \] *** 확인해주신 "통계산기" 수강생님께 감사드립니다.
● [7장 Comparison Between Estimators] 56강 연습문제 풀이 (3) (43분 30초경 부터)
Question 7(b)번을 풀이하고 최종 결과를 적어드리는 과정에서 오타가 있었습니다.
\[ \widehat{\theta}(y) = \frac{y^{n+1} - (y-1)^{\color{red} n-1}}{y^n - (y-1)^n} \qquad\Longrightarrow\qquad \widehat{\theta}(y) = \frac{y^{n+1} - (y-1)^{\color{red} n+1}}{y^n - (y-1)^n} \] *** 확인해주신 "12A" 수강생님께 감사드립니다.
● [교재 9장 Inference on Normal Models] 29페이지 Two-way Classification Model w/ Interaction
해당 모형에서 모든 그룹의 관측치 숫자는 같다는 다음의 가정을 추가해주셔야 합니다:
\[ n_{ij} = m \qquad\text{for all}~ 1\leq i\leq a ~~\text{and}~~ 1\leq j\leq b. \] 해당 가정은 이후의 논리전개 과정에서 다음의 식 등에 반드시 필요합니다:
\[ \sum_{i=1}^a (\overline x_{\cdot\cdot\cdot} - \overline x_{i\cdot\cdot}) = 0. \] 만약 모든 그룹의 관측치 숫자가 같지 않다면, 전체모형의 MLE나 LRT가 조금씩 달라지게 됩니다. 예를 들면 \(\widehat\alpha_i\)는 아래와 같이 유도할 수 있습니다.
\[ \widehat\alpha_i = \overline x_{\cdot\cdot\cdot} - \frac{n_{i\cdot} a}{n} \overline x_{i\cdot\cdot} \qquad\text{due to}~ \sum_{i=1}^a \left( \overline x_{\cdot\cdot\cdot} - \frac{n_{i\cdot} a}{n} \overline x_{i\cdot\cdot} \right) = 0. \] *** 확인해주신 "그다이" 수강생님께 감사드립니다.
● [9장 Inference on Normal Models] 73강 One-way Classification Model (3) (6분 35초경 부터)
21페이지 증명과정에서 두 가지 확률변수 \(V \sim \chi^2(a-2)\)와 \(Z \sim N(\sqrt{\delta},1)\)가 독립일 때, 왼쪽의 결과가 성립한다 설명드렸습니다. 하지만 이는 잘못된 것으로 오른쪽과 같이 수정해주셔야 합니다.
\[ V+Z^2 \sim \chi^2({\color{red} a-2};\delta) \qquad\Longrightarrow\qquad V+Z^2 \sim \chi^2({\color{red} a-1};\delta) \] *** 확인해주신 "통계란찜" 수강생님께 감사드립니다.
● [9장 Inference on Normal Models] 78강 Testing Independence (1) (25분 50초경 부터), 79강 Testing Independence (2) (1분 53초경 부터)
표본 공분산 \(\widehat{\rho}\)를 왼쪽과 같이 잘못 설명드렸습니다. 오른쪽과 같이 바꾸어주셔야 합니다.
\[ \widehat{\rho} = \frac{S_{XY}}{S_{XX} {\color{red} S_{XY}}} \qquad\Longrightarrow\qquad \widehat{\rho} = \frac{S_{XY}}{S_{XX}{\color{red} S_{YY}}} \] *** 확인해주신 "통계란찜" 수강생님께 감사드립니다.
# 선형대수/회귀분석
● [교재 0장 Linear Algebra: Basics for Regression Analysis] 63페이지 Rank: Example
Column space \(\mathcal C_A\)는 \(\mathbb R^2\)가 아닌 \(\mathbb R^3\)의 subspace로 고쳐주셔야 합니다.
*** 확인해주신 "Ljsstudy" 수강생님께 감사드립니다.
● [0장 Linear Algebra: Basics for Regression Analysis] 3강 Vector Calculus (19분 5초경 부터)
교재의 Proposition 5를 증명하는 과정에서 칠판에 적어드린 부분에 실수가 있었습니다. 아래의 수식과 같이 빨간색으로 표기한 \(x_2, x_3, \ldots, x_n\)을 모두 \(x_i\)로 바꾸어주셔야 합니다.
\[ \frac{\partial u}{\partial x}=2\begin{pmatrix}\sum{a_{ik}x_i} \\\sum{a_{ik}{\color{red} x_2}} \\ \vdots \\ \sum{a_{ik}{\color{red} x_n}} \\\end{pmatrix} \quad\Longrightarrow\quad \frac{\partial u}{\partial x} = 2\begin{pmatrix}\sum{a_{ik}x_i} \\\sum{a_{ik}{\color{red} x_i}} \\ \vdots \\ \sum{a_{ik}{\color{red} x_i}} \\\end{pmatrix}\] *** 확인해주신 "설통가고파" 수강생님께 감사드립니다.
● [1장 Multivariate Normal Distribution] 31강 Quadratic Form (2) (18분경 부터)
해당 강의내용을 보시면 Theorem 11번의 가정에 \(B\)가 "idempotent라는 가정을 추가"한 상태에서 (a)번의 일부, \(A\Sigma B=0\) 이면 \(AX\)와 \(X^\top BX\)가 독립이다라는 사실을 증명해드린다고 설명드립니다. 하지만 이 내용이 편집상의 오류로 삭제되었고 곧바로 Theorem 11의 증명으로 넘어갑니다. 따라서 강의에서 삭제된 부분은 여기에 글로 설명드리고자 합니다.
우선 \(B\)가 symmetric idempotent (orthogonal projection) matrix이므로 다음이 성립합니다.
\[ X^\top B X = X^\top B^2 X = X^\top B^\top B X = \lVert BX \rVert_2^2 \] 그런데 앞의 기본적인 multivariate Gaussian의 성질로부터 \(A\Sigma B=0\)이면 \(AX\)와 \(BX\)가 독립이라는 사실은 이미 알고있습니다. 그리고 \(AX\)와 \(BX\)가 독립이면 자연스럽게 \(AX\)와 \(\lVert BX \rVert_2^2\)도 독립이므로 원하는 결과를 얻을 수 있습니다.
*** 확인해주신 "Josh" 수강생님께 감사드립니다.
● [교재 3장 Multiple Linear Regression] 26페이지 Corollary 10
Corollary 10의 첫 줄에서 "simple" linear regression이 아닌 "multiple" linear regression으로 수정해주셔야 합니다.
*** 확인해주신 "12A" 수강생님께 감사드립니다.
● [3장 Multiple Linear Regression] 47강 Multiple Linear Regression Model (12분 10초경 부터)
강의노트 5페이지의 REMARK를 설명드리는 부분입니다. 강의영상을 통해 보이는 슬라이드를 보시면, 인쇄된 강의교재와 design matrix \(X\)의 성분들의 인덱스가 다르게 서술되어 있습니다. 이는 인쇄된 강의교재가 맟고, 강의영상을 통해 보이는 슬라이드는 잘못된 것입니다. 하지만 강의영상에서의 설명은 인쇄된 강의교재 (맞는 notation)을 바탕으로 합니다. 다시 말해서 design matrix의 \(i\)번째 행의 \(j\)번째 열 성분에 해당하는 \(x_{ij}\)는 \(i\)번째 관측치의 \(j\)번째 설명변수의 관측값을 의미합니다. 이후의 강의에서도 해당 notation을 지속적으로 사용하니 반드시 기억해주시면 좋겠습니다.
● [3장 Multiple Linear Regression] 48강 Method of Estimation (1) (31분 50초경 부터)
Design matrix를 전치한 \(X^\top\) 행렬을 아래와 같이 block matrix 형태로 풀어서 쓰는 부분입니다.
\[ X^\top = \begin{bmatrix} \mathbf1^\top \\ x_1^\top \\ \vdots \\ x_p^\top \end{bmatrix} \] 강의에서 해당 행렬이 \(n\times1\) block matrix라고 설명을 드렸지만, 이는 잘못된 설명으로 \((p+1)\times1\) block matrix가 되어야 맞습니다. 참고로 이와 같이 설명을 바꾸더라도 block matrix의 행렬곱은 여전히 잘 정의되므로, 이 이후에 강의에서 설명드린 내용도 여전히 성립합니다.
*** 확인해주신 "통계란찜" 수강생님께 감사드립니다.
● [3장 Multiple Linear Regression] 57강 Confidence Interval (2) (14분경 부터)
해당 파트에서 \(\widehat{\beta}\)의 분포를 설명드리면서 \(\widehat{\beta} \sim N_p(\ldots)\)로 칠판에 적어드렸습니다. 다만 \(\widehat{\beta}\)는 \(p+1\)차원 random vector이므로 빨간색으로 표기한 부분과 같이 차원을 수정해주셔야 합니다.
\[\widehat{\beta} \sim N_{{\color{red} p+1}}(\ldots)\] *** 확인해주신 "설통가고파" 수강생님께 감사드립니다.
● [4장 Multiple Linear Regression: General Testing] 65강 Constrained Least Square Estimation (3) (18분 15초경 부터)
해당파트에서 \(U(\beta_r, \lambda)\)라는 함수를 정의합니다. 그러나 이를 풀어서 전개하는 과정에서 부호에 실수가 있었습니다.
\[ \begin{aligned} &U(\beta_r, \lambda) = (y - X\beta_r)^\top (y-X\beta_r) - \lambda^\top A \beta_r = \beta_r^\top X^\top X \beta_r {\color{red} \,+\,} \beta_r^\top (A^\top \lambda {\color{red} \,-\,} 2X^\top y) + y^\top y \\ &\Longrightarrow U(\beta_r, \lambda) = (y - X\beta_r)^\top (y-X\beta_r) - \lambda^\top A \beta_r = \beta_r^\top X^\top X \beta_r {\color{red} \,-\,} \beta_r^\top (A^\top \lambda {\color{red} \,+\,} 2X^\top y) + y^\top y \end{aligned} \] *** 확인해주신 "설통가고파" 수강생님께 감사드립니다.
● [4장 Multiple Linear Regression: General Testing] 65강 Constrained Least Square Estimation (3) (30분 30초경 부터)
강의를 보시면 Theorem 10의 증명을 시작하면서 다음을 만족하는 \(\beta_r^0\in\mathbb R^{q}\)를 잡습니다.
\[ A\beta_r^0 = t \] 하지만 행렬의 차원을 잘 살펴보시면 \(\beta_r^0\in\mathbb R^{q}\)이 아닌 \(\beta_r^0\in\mathbb R^{p+1}\)를 잡아주어야 합니다. 이와 같이 잡아준 벡터의 차원을 바꾸어주더라도 이후의 논리전개에 영향을 미치는 부분은 없습니다.
*** 확인해주신 "수통챙겨라" 수강생님께 감사드립니다.
● [5장 Model Validation and Diagnostics] 75강 Lack of Fit Test (1) (30분경 부터)
해당 파트에서 \(\overline y_i\)의 정의를 왼쪽과 같이 적어드렸는데, 오른쪽과 같이 수정해주셔야 합니다.
\[ \overline y_i = {\color{red} \frac{1}{n}} \sum_{j=1}^{r_i} y_{ij} \quad\Longrightarrow\quad \overline y_i = {\color{red} \frac{1}{r_i}} \sum_{j=1}^{r_i} y_{ij} \] *** 확인해주신 "skarbtjr" 수강생님께 감사드립니다.
● [6장 Non-full-rank Model] 77강 One-way ANOVA Model (1) (39분경 부터)
One-way ANOVA 모형의 다른 제약조건을 설명드리면서 적어드린 summation의 index에 오류가 있었습니다.
\[ \sum_{i=1}^{\color{red} n} n_i \tau_i = 0 \qquad\Longrightarrow\qquad \sum_{i=1}^{\color{red} k} n_i \tau_i = 0 \] *** 확인해주신 "Ljsstudy" 수강생님께 감사드립니다.
● [교재 7장 Biased Regression] 14페이지 Theorem 10의 Remark
Theorem 10의 Remark는 \(k>0\)인 경우에만 성립하는 내용입니다. \(k=0\)인 경우 ridge estimate은 OLS estimate과 일치하고 Theorem 10에 따라서 \(\lVert \widehat\gamma \rVert^2 = d\)이 자명하게 성립합니다.
*** 확인해주신 "qwe123" 수강생님께 감사드립니다.
● [7장 Biased Regression] 83강 Ridge Regression (2) (29분 53초경 부터)
Ridge estimate \(\widehat{\gamma}^R(k^*)\)의 MSE를 적어드리는 부분에서 아래와 같이 빨간색으로 표기한 부분을 추가해주셔야 합니다.
\[ \mathrm{MSE}(\widehat{\gamma}^R) = \mathrm{tr}\bigl( \mathrm{Var}(\widehat{\gamma}^R) \bigr) + ({\color{red} \mathbb E}\widehat{\gamma}^R - \gamma)^\top ({\color{red} \mathbb E}\widehat{\gamma}^R - \gamma) \] *** 확인해주신 "qwe123" 수강생님께 감사드립니다.
● [교재 8장 Model Selection and Assessment] 27페이지부터 29페이지까지
교재 27페이지 backward selection 파트에서 \(S_0\) 집합은 다음과 같이 모든 index로 설정해주셔야 합니다.
\[ S_0 = \{1,2,\ldots,{\color{red} p}\}. \] 한편 backward selection에서는 한 단계마다 변수를 하나씩 제거해주므로 \(S_{k-1}\)에는 총 \(p-k+1\)개의 변수가 선택됩니다. 따라서 \(F_{k,j}\) 통계량은 다음과 같이 수정해주셔야 합니다.
\[ F_{k,j} = \frac{\mathrm R(\beta_j \mid \beta_0, \beta_\ell:\ell\in S_{k-1}\backslash\{j\})}{\mathrm{SSE}(\beta_0, \beta_\ell:\ell\in S_{k-1})/{\color{red} (n-p+k-2)} } \] 같은 맥락에서 교재 28-29페이지 stepwise selection 파트에서는 \(k\)번째 단계에서 선택되는 변수의 개수가 유동적입니다. 그러므로 \(S_k\)라는 집합의 원소의 개수를 \(|S_{k}|\)로 표기하고 \(F_{k,j}\)와 \(F^*_{k,j}\) 통계량을 다음과 같이 수정해주셔야 합니다.
\[ \begin{align*} F_{k,j} &= \frac{\mathrm R(\beta_j \mid \beta_0, \beta_\ell:\ell\in S_{k-1})}{\mathrm{SSE}(\beta_0, \beta_\ell:\ell\in S_{k-1},\beta_j)/{\color{red} (n-|S_{k-1}|-2)} } \\ F^*_{k,j} &= \frac{\mathrm R(\beta_j \mid \beta_0, \beta_\ell:\ell\in S_{k-1}\backslash\{j\})}{\mathrm{SSE}(\beta_0, \beta_\ell:\ell\in S_{k})/{\color{red} (n-|S_k|-1)} } \end{align*} \] *** 확인해주신 "케어베어" "조성재" 수강생님께 감사드립니다.